
前面我們已經實作過 MCP 的 Tool、Resource 和 Prompt,讓 AI 可以透過 Tool 執行操作、透過 Resource 取得資料,也能使用預先設計好的 Prompt,不過 MCP 還有一個有趣的功能:Sampling。
通常我們會在 Client 端呼叫 AI 模型,再透過 MCP 使用 Server 提供的功能。但如果 MCP Server 在執行任務時,也需要 AI 幫忙生成內容,可以怎麼做?
這時候就可以使用 MCP Sampling,讓 Server 向 Client 請求 AI 模型生成內容,今天就來實際做一個簡單的 Sampling,看看它是怎麼運作的。
首先建立 server.py,這次會建立一個名為 ask_ai 的 Tool,讓使用者可以提出問題,再由 Server 透過 Sampling 請求 AI 生成回答。
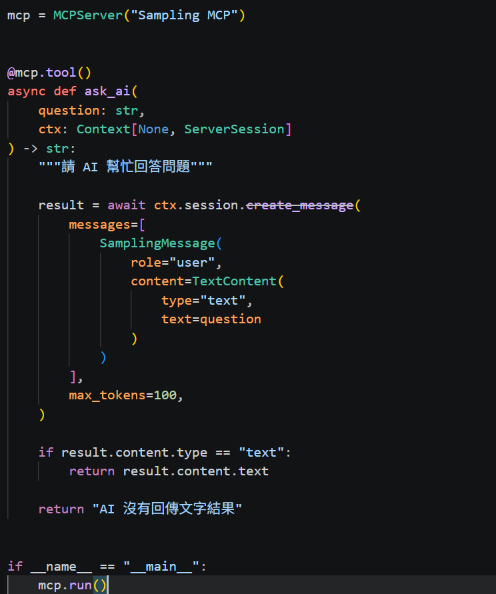
這裡比較重要的是 ctx.session.create_message(),前面建立的 Tool 通常是讓 Server 執行某個功能,而這次則是透過 create_message() 發出 Sampling Request,請求 Client 端的模型生成內容。
其中,messages 用來傳遞要詢問的內容,而 max_tokens 則是限制模型回覆的最大 Token 數量。
接著建立 client.py,這次除了連接 MCP Server,也需要讓 Client 能夠處理 Sampling Request,因此會在建立 ClientSession 時設定 sampling_callback。
收到請求後,我們就呼叫 Gemini API,取得回答後再回傳給 Server。
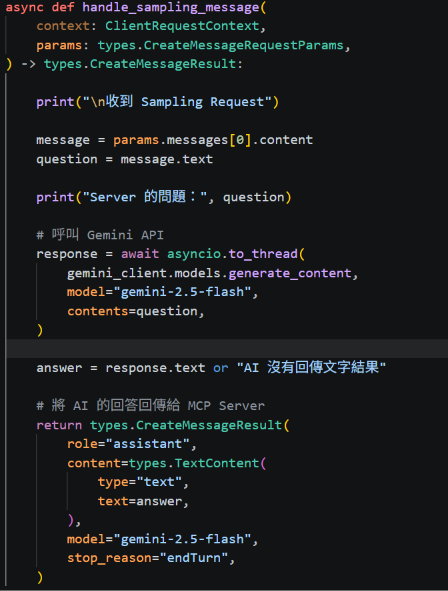
這裡只列出處理 Sampling 的主要程式碼。sampling_callback 負責處理 Server 傳來的請求,而 generate_content() 則是實際呼叫 Gemini 生成回答。取得結果後,再透過 CreateMessageResult 將內容回傳。
要注意的是,Sampling 並不是讓 Server 直接連接 Gemini API。這次的實作仍然由 Client 負責呼叫模型,因此 API Key 也只需要設定在 Client 端。
完成後,在終端機切換到 day25 資料夾開始測試,這次讓 Client 呼叫 ask_ai,並詢問:「什麼是 MCP Sampling?請用簡單的方式解釋。」
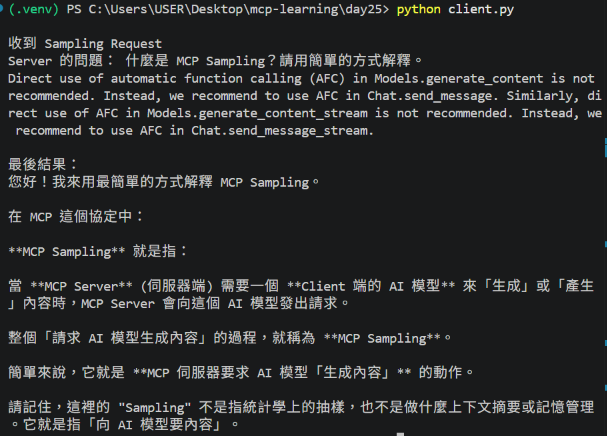
執行後,可以看到 Server 發出 Sampling Request,由 Client 呼叫 Gemini API 生成回答,再將結果回傳給 Server。從測試結果可以確認,這次已經成功完成 Sampling 的請求與回應流程。
今天我們實作了 MCP Sampling,讓 MCP Server 除了提供 Tool 之外,也能在執行過程中請求 AI 模型生成內容,這次最重要的觀念是:Sampling 讓 Server 能夠請求模型生成內容,但實際使用哪個模型,以及如何處理請求,仍由 Client 端決定。
透過這個功能,MCP Server 就能在需要 AI 協助時,向 Client 發出請求,而不必自行管理模型 API。


 iThome鐵人賽
 看影片追技術